
Christoph Haag
Christoph ist Softwareentwickler mit einer Passion für Musik
23.09.2026 | 13 min Lesezeit
Softwareentwicklung mit KI-Agents: alles anders, alles gleich
Prinzipien und Best-Practices in Zeiten von Agents
Die tägliche Arbeit mit KI-Agents hat meine Arbeitsweise verändert. Und trotzdem denke ich immer wieder: Eigentlich ist alles gleich, nur die Art, ein Problem zu lösen, ist anders.
The more things change, the more they stay the same (frei nach Jean-Baptiste Alphonse Karr, 1849)
Auch vor KI gab es Code-Reviews, Software-Tests, Dokumentation und kontinuierliche Verbesserungsprozesse. Was sich ändert, ist nicht das Was, sondern das Wie. Genau darum soll es in diesem Beitrag gehen: einige Bereiche, in denen ich das in den letzten Monaten besonders deutlich gelernt habe.
Code-Reviews
Wer kennt es nicht? Man hat ein Feature entwickelt (oder ein anderer Entwickler) und meint, alle Anforderungen umgesetzt zu haben. Man geht die Akzeptanzkriterien durch. Alle erfüllt. Manueller Test der Applikation. Funktioniert. Die Änderungen gehen live. Und es stellt sich heraus: Es funktioniert doch nicht alles wie gewünscht. Ein neuer Bug - oder gleich mehrere - wandert ins Backlog und wird umgesetzt. Im schlimmsten Fall kann sich das mehrere Runden drehen und es stellt sich die Frage: "Woran hat's jelegen?"
Bei der Arbeit mit Agents ist mir Ähnliches passiert, nur - anders. Der Agent hat seine Arbeit nach Plan abgeschlossen: "ready to merge". Alle Teilaufgaben wurden abgehakt und automatisiert getestet. Nach dem Ausliefern stellt man dann fest, dass das ein oder andere doch nicht so funktioniert wie gewünscht.
Ich habe den Agent daraufhin angewiesen, die App vor dem Merge visuell zu testen. Also wie ein Entwickler, der seine Änderungen selbst in der laufenden Anwendung validiert. In der Folge hat der Agent dann häufig beim Durchklicken einige Probleme festgestellt. Sein Vorschlag: Lege ein neues Issue dafür an. Stellenweise waren das drei bis vier neue Issues, die aus einem Issue entstanden sind. Das waren Dinge unterschiedlichster Art. Von einfachen Bugs über Edge-Cases, die erst einmal auftreten müssen, über Fehlverhalten an ganz anderer Stelle der App, bis hin zu wirklich grundlegenden Fehlern, die aber den Scope des Issues gerade übersteigen - und der PR ist ja eh schon groß (so die Meinung des Agents).
In einem Team aus Entwicklern wird man versuchen, über Retrospektiven, Meetings und manchmal auch im Alleingang nach Lösungsmöglichkeiten zu suchen, die meist darin bestehen: Bug-Dashboards, mehr automatische Tests, mehr Reviews, selbst gründlicher testen, auf dem Zielgerät/der Zielumgebung deployen, ein PR darf nur gemerged werden, wenn er auch wirklich fertig ist, die Akzeptanzkriterien einzeln durchgehen, die Feature-Beschreibung verbessern und vieles mehr.
Ich habe den Agent nach einigen Tagen, nachdem mich das wirklich gestört hat, gefragt: "Ich habe den Eindruck, dass jedes Issue zu mehreren neuen Issues führt. Wie können wir das verbessern?" Der Agent hat meine Sessions, das Backlog und abgeschlossene Issues durchsucht und meine Vermutung bestätigt. Meist übertreibt er in solchen Fällen: "Es ist noch viel schlimmer als gedacht" - genau mein Humor. Seine weitere Analyse: Wenige PRs der betrachteten vergangenen Wochen wurden kommentiert - es gab kein sichtbares oder effektives Code-Review. Sein Vorschlag: konsequent Code-Reviews durchführen und die Ergebnisse transparent im PR als Kommentare hinterlassen. Und zwei Ergänzungen in der Agent-Instruction-Datei:
Review findings about the branch under review are fixed on that branch before merge — they never become follow-up issues. Shipping mature means the review's findings are part of the work.
Adjacent/pre-existing findings pass a triage gate before filing: does it corrupt data, break a user-visible flow, or violate a standing invariant? If yes → file; if trivial → fix inline; otherwise dropping it is a valid outcome.
Die Folge seitdem: weniger Bugs im Backlog. Und die Themen, die aufkommen sind eine eigene Design-Phase wert.
Dasselbe Problem wie in einem menschlichen Entwicklungsteam, nur die Herangehensweise/Lösung ist eine andere - und Agents befolgen diese Instruktionen unmittelbar (wobei "befolgen" eine eigene Geschichte ist, dazu später mehr). Bei Entwicklern kann das eine zeitaufwendige Kultur-Änderung bedeuten.
Tests
Gute Tests sind schwieriger, als man meinen mag. Ein Test, der grün ist, beweist noch nicht, dass er etwas beweist. Zwei typische Probleme:
Schlechter Input. Das Test-Szenario erreicht den zu testenden Pfad nicht. Setup und Testdaten sehen plausibel aus, triggern aber weder bei korrekter noch bei fehlerhafter Implementierung das eigentliche Verhalten.
Schlechte Assertion. Der Code-Pfad wird zwar erreicht, aber die Überprüfung (Assertion) ist zu ungenau.
Beide Fälle haben dieselbe Konsequenz: Eine echte Verhaltensänderung im Code bleibt unbemerkt (Regression), weil der Test strukturell nicht in der Lage ist, sie zu erkennen.
Dieser Fehler ist nicht neu. Er passiert erfahrenen Entwicklern genauso wie Agents. An der Fehlerart selbst hat sich nichts geändert. Verstärkt wird das Problem aber durch die schiere Menge an Code und Tests, die ein Agent in kurzer Zeit produzieren kann. Tests geben ein Gefühl von Sicherheit, und eine große, grün leuchtende Test-Suite erweckt schnell den Eindruck, dass alles in Ordnung ist. Paradoxerweise kann eine große Anzahl an Tests sogar hinderlich sein: Jeder einzelne Test kann auf die beschriebene Weise fehlerhaft sein, und mehr Tests bedeuten mehr Review-Aufwand, um das zu erkennen. Im schlimmsten Fall wird sogar falsches Verhalten in einem Test festgehalten.
Was hat sich verändert durch Agents? Die Ursachenforschung; aus einer Vermutung Fakten schaffen; Probleme klassifizieren und dadurch gezielt gegensteuern.
Ich habe dem Agent meine Intuition geschildert und ihm die Aufgabe gegeben, alle Kommentare von PRs zu finden, die auf falsche oder schlechte Tests hindeuten.
Daraus ergaben sich genau die oben beschriebenen zwei Ursachen:
- "The scenario never reaches the behavior being tested" (schlechter Input)
- "The assertion checks a coarser signal than the thing it's named for" (schlechte Assertion)
Am Ende landete eine neue Anweisung in der Agent-Instruction-Datei und konkretere Schritte und Hintergründe wurden in einer weiterführenden coding-guidelines Dokumentation ergänzt.
Any new test earns its place only after it's been proven red: break the one line of logic it claims to cover — comment out a check, flip a branch, swap a fallback value — confirm the test fails, then revert. A test that stays green under that mutation doesn't pin anything; strengthen the input or the assertion until it does.
Mit dieser Anpassung meldete der Agent bei der nächsten Implementierung neuer Tests: "Every new test was proven red by mutating the line it covers". Das wirft die Folge-Frage auf: Kann ich dem Agent vertrauen, dass er genau das gemacht hat? Ansonsten bleibt es eine Behauptung. Ich habe den Agent gefragt, ob er diese Behauptung beweisen kann. Die Antwort: "my claim was overstated", "'Every new test' was wrong". Der Agent hat die Anweisung dann ausgeführt und zurückgemeldet: "You had to trust it. Now you don't — and the check was worth running".
Um gegenzusteuern, habe ich eine Liste im Pull-Request eingeführt, die ausgefüllt werden muss, anstatt einfach nur eine Zusammenfassung.
Ich mache es dem Agent also schwerer, eine Abkürzung zu nehmen.
Verhindern kann ich es damit aber immer noch nicht. Die Ergebnisse seitdem sind überzeugend.
Hier ein kleiner Auszug aus einem GitHub PR (die gesamte Liste besteht aus über 30 Einträgen). Entscheidend: survived -> fixed. Der Agent hat also einen schlechten Test gefunden und ihn verbessert.
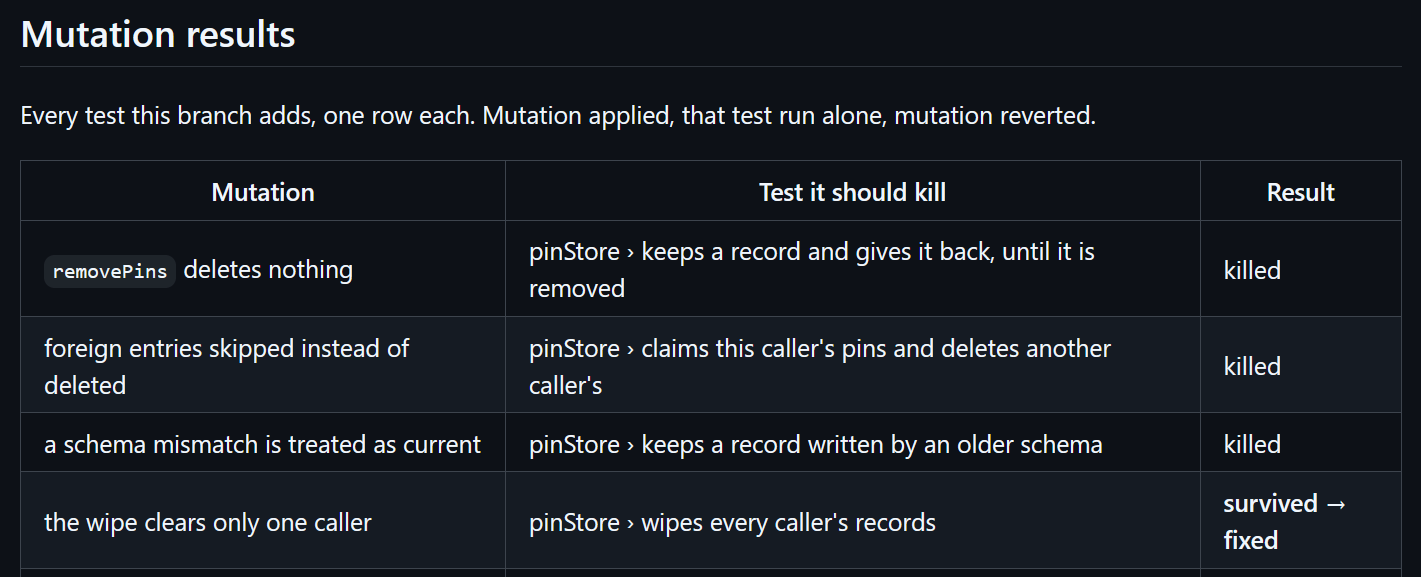
Und das ist vielleicht das größte Learning hier: Bisher waren solche Regeln in den Köpfen der Entwickler oder irgendwo dokumentiert. In einem Team musste man darauf vertrauen (Disziplin, Reviews, Pairing), dass diese Regeln/Best-Practices umgesetzt werden.
Eine Anweisung wie die obige (proven-red test) in einem Entwicklungsteam zu etablieren, ist komplex und zeitaufwendig. Mit Agents werden diese Regeln ausführbar - theoretisch. Es braucht Überwachung und Beweise, dass Anweisungen befolgt werden. Dieselbe Fehlerklasse eine Ebene höher: Ein grüner Test, der etwas behauptet, was er nicht prüft und ein Agent, der behauptet eine Regel befolgt zu haben, die er nicht befolgt hat.
Code-Architektur
Ein Konzept, das mich als Entwickler entscheidend vorangebracht hat, ist Cohesion: Dinge, die dieselbe Aufgabe haben, gehören auch im Code zusammen. Was dieselbe Aufgabe hat, ändert sich meist aus denselben Gründen und zur selben Zeit. Umgekehrt gilt: Ändert sich eine Sache ständig und etwas anderes nie, haben sie vermutlich verschiedene Aufgaben und sollten getrennt werden.
Sowohl Agents als auch Entwickler neigen dazu, eine neue Anforderung in ein bestehendes System zu "pflastern". Die Anforderung wird verstanden, der Status quo wird verstanden, das nach außen sichtbare Verhalten stimmt. Alles scheint zu passen. Wiederholt sich dieser Kreislauf ein paar Mal, entsteht Code, den irgendwann niemand mehr durchschaut: verschachtelte if/else-Ketten, verschiedene Abstraktionsebenen direkt nebeneinander (z.B. wichtige Logik neben Netzwerk-Aufrufen, Fehlerbehandlung vermischt mit Übersetzungen), Abhängigkeitsketten, die man "einfach wissen" muss.
Ein konkretes Beispiel aus einer React-Anwendung: Ein grafischer Editor bekam "Tools" für verschiedene Eingabemethoden auf einer Zeichenfläche. Zu Beginn gab es genau ein Tool, keine Unterscheidung nötig. Dann kam ein zweites dazu - zunächst als Prototyp, um zu prüfen, ob es überhaupt Mehrwert bringt. Es bewährte sich, weitere folgten. Mit der Zeit waren es neun Tools, und der Code bestand aus einem Gewirr von if/else-Bedingungen, bei dem nicht mehr klar war, welches Tool sich wie und warum verhält. Aus einer Lösung, die für ein einzelnes Tool völlig ausreichend war, wurde ein Feature, das ein ordentliches Design und Architektur braucht.
Der Agent kam mit diesem Chaos zunächst gut zurecht - jede neue Anforderung und jede Bug-Beschreibung ließ sich umsetzen. Aber irgendwann führte eine Änderung zu einem Fehlverhalten an einer ganz anderen Stelle, "an der man doch gar nichts verändert hatte".
Die Lösung war eine konzeptuelle Betrachtung: Was haben alle Tools gemeinsam? Sie reagieren auf Events - und die Events sind für alle Tools identisch. Nur das Verhalten auf diese Events ist pro Tool unterschiedlich. Die Trennung nach Cohesion sah entsprechend so aus: eine zentrale Stelle bereitet Events so auf, dass sie für Tools einfach nutzbar sind (ändert sich selten); pro Tool gibt es eine eigene Datei, die diesen Events Bedeutung zumisst (ändert sich häufig; bzw. neue Tools lassen sich hinzufügen, ohne bestehende anzupassen).
Das entstandene Chaos hätte von einem Menschen oder von einem Agent stammen können - das war letztlich egal. Entscheidend ist der Zeitpunkt, an dem man erkennt, dass der Status quo verbesserungswürdig ist. Dafür braucht es entweder einen erfahrenen Entwickler oder passende Heuristiken und Skills, mit denen ein Agent selbst bemessen kann, wann dieser Zeitpunkt erreicht ist. Hier stehe ich noch am Anfang, wie ich das mit Agents automatisieren kann. Die oben genannte unerwartete "Fernwirkung" wäre ein geeignetes Alarmsignal (der improve-codebase-architecture Skill von Matt Pocock geht in diese Richtung und ist einen Blick wert). Man muss dabei nicht im Voraus die perfekte Architektur entwerfen - die kennt man zu Beginn ohnehin meist noch nicht. Aber ein guter Entwickler erkennt, wann es Zeit für Veränderung ist. Genau diese Fähigkeit muss man sich auch im Umgang mit Agents bewahren.
Dokumentation
Dokumentation war schon immer gewünscht, aber sie von Hand zu schreiben ist und bleibt langwierig. Mit Agents-in-the-loop (Idee, Design & Architektur, Abwägen von Alternativen, Entscheidungen treffen, Implementierungsplan erstellen) entfällt das Schreiben (größtenteils) - nicht das Denken. Gründliches Lesen und Validieren wird zum Zeitfresser. Text von einer KI sieht überzeugend und plausibel aus; viel Text kann einen erschlagen - der Fehler liegt im Detail und den gilt es zu finden, bevor die Dokumentation "live" geht.
Neu ist, dass Dokumentation unmittelbar einen Unterschied macht. Sie ist nicht mehr nur Kommunikation zwischen Menschen, um Dinge festzuhalten, die der Code nicht oder nur sehr implizit hergibt. Sie wird zu etwas, das das Verhalten von Coding-Agents aktiv beeinflusst - mit dem Vorbehalt aus dem Tests-Abschnitt.
Die größte Langzeit-Herausforderung dabei ist, Herr über das entstehende Chaos zu bleiben: Viel Dokumentation macht einen regelmäßigen Abgleich erforderlich, ob sie noch aktuell ist. Während sie früher oft zu kurz kam, könnte die neue Herausforderung eher in Richtung Über-Dokumentation gehen. Und: veraltete Dokumentation kostet umso mehr.
Meine aktuelle Lösung dafür ist ein zusätzlicher Schritt zu Beginn eines Features bzw. der Planungsphase. Der Agent soll Code, Dokumentation und Backlog/ Issues abgleichen ("reconciliation"), um Unstimmigkeiten möglichst früh zu finden und gegensteuern zu können. Nach Abschluss eines Features wird auf verlinkten Issues ein Kommentar hinterlassen mit Informationen, was umgesetzt wurde und wenn sich Annahmen geändert haben. Inwieweit das schon ausreicht, wird sich erst noch zeigen müssen.
Tempo und Wissenstiefe
Agents sind gleichzeitig klüger und dümmer als man selbst. Sie "wissen" sehr viel mehr als ich - sowohl in der Breite als auch in der Tiefe. Sie lesen und schreiben Code oder allgemein Text schneller als ich. Und trotzdem machen sie Fehler.
Man kommt schnell in Versuchung, Agents eine große Aufgabe zu geben, ENTER zu drücken, ein paar Minuten oder sogar Stunden zu warten und zu hoffen oder zu erwarten, dass das Richtige dabei herauskommt. Das kann funktionieren, ist oft aber Glücksspiel.
Als Entwickler schreibe ich sehr viel weniger Code von Hand - und damit bin ich nicht alleine. Trotzdem muss ich das Problem/die Aufgabe in der Tiefe verstanden haben. Ich muss mir über (sehr viel mehr) Dinge im Voraus Gedanken machen. Der Planungsprozess wird intensiver, Coding wird automatisiert. Meinen genauen Prozess möchte ich hier gar nicht näher beschreiben, das ist heute so, morgen so. Mein Punkt ist der: Der Abstraktionsgrad ändert sich. Die Wissenstiefe ändert sich. Ich muss nicht wissen, wie ein topologischer Sortieralgorithmus für gerichtete azyklische Graphen funktioniert, ich muss vielleicht nicht einmal wissen, dass es diesen Algorithmus gibt, aber ich muss in der Lage sein, zu validieren und zu bewerten, ob es die richtige Wahl ist, wenn ich ihn einsetze. Ich gewinne an Tempo, verliere aber Wissenstiefe und muss dennoch den Überblick behalten.
Das verändert, wie man lernt. Das Sachwissen bleibt eher an der Oberfläche, nachhaltiges Lernen - Algorithmen, Datenstrukturen etc. - ist fraglich. Stattdessen lerne ich aktuell andere Themen: Spezifikation von Aufgaben, mehr High-Level-Architektur, Agents in Schranken weisen, Multitasking und vieles, vieles mehr. Wie das zu bewerten ist, ist für mich noch offen - wahrscheinlich aber schlicht ein unausweichlicher Wandel, mit Vor- und Nachteilen.
Fazit
Nüchtern betrachtet fällt mein Fazit nach einigen Monaten so aus: Erlernte Prinzipien haben weiterhin Bestand. Ich halte Best-Practices, Guidelines und Learnings in Dokumentationen fest. Saubere Tests, Trennung von Verantwortlichkeiten und Code-Reviews sind nach wie vor essenziell. Manches wird wichtiger und dringlicher als vorher, weil Agents in kurzer Zeit mehr produzieren, als man nebenbei prüfen kann. Dokumentation bekommt eine gewisse Durchsetzungskraft. Sie ist mehr als nur Appell, aber keine Garantie. Und wenn sie veraltet ist, kann sie sogar zum Problem werden.
Aber: Meine Rolle hat sich verändert. Ich schreibe weniger Code, formuliere mehr Anweisungen und lese mehr. Ich muss den Überblick behalten und viel mehr Themen im Voraus bedenken, die bisher on-the-fly erledigt wurden. Notwendig, aber auch sehr anstrengend. Ich werde de facto zum Lead-Entwickler.
Ich bin gespannt, wie sich die Dinge in den nächsten Monaten und Jahren entwickeln. Bei codeunity haben wir "vor KI" Software geschrieben und werden es auch mit KI weiterhin tun. Alles gleich und doch anders.